Product & UI · Oct 20, 2026
@nakazakifam 님의 AI 비디오 팟캐스트를 보고 저도 ComfyUI로 만들어봤습니다.
@nakazakifam 님의 AI 비디오 팟캐스트를 보고 저도 ComfyUI로 만들어봤습니다. by Seulki Ji. Watch the Product & UI video and visit the original X post.

Seulki Ji@passeth_me
View on X@nakazakifam 님의 AI 비디오 팟캐스트를 보고 저도 ComfyUI로 만들어봤습니다. 회사 블로그 글과 출연자 이미지 두 장을 건네고 "이걸로 영상 만들어줘"라고 해본 실험이에요. 원작만큼의 완성도는 아니지만, 재미 삼아 시켜본 것치고는 결과가 꽤 괜찮네요. 🛠 구성 · ComfyUI + LTX-2.3: 사진 + 음성 → 립싱크 영상 · ElevenLabs v4: 대사 더빙 · Qwen-Image-Edit: 표정·시선 보정 · 파이썬: 컷 편집, 줌, 화면 분할, 모션그래픽, 자막 합성 🎬 과정 글 → 1분 대본(질문자/답변자 11마디) → 음성 생성 → 컷마다 말하는 클립과 듣는 리액션 클립 렌더링 → 클로즈업·펀치인·화면 분할로 편집 → 챕터·체크리스트 그래픽 얹기 ⏱ 시간과 비용 RTX 4090 로컬 환경에서 1분 남짓한 영상의 첫 버전이 나오기까지, Claude(Opus)가 기획부터 편집까지 맡아 약 30분이 걸렸습니다. 6초 클립 하나에 약 40초씩 렌더링돼요. 이 과정을 스킬로 정리해 두면 다음부터는 생성 위주로 돌릴 수 있어서, 1분 영상 하나에 10~20분 정도면 될 것 같아요. 비용은 ElevenLabs 더빙 말고는 들지 않습니다. 💡 배운 것 ① 입 모양 품질은 모델보다 원본 사진 해상도가 좌우해요. ② AI에게 연출을 말로 시키면 엇나가요. "상대를 보며 웃어"라고 했더니 비웃는 표정, 카메라 패닝, 없던 사람까지 등장 😅 결국 사진 자체를 먼저 편집해서 시선과 표정을 정해 두는 게 답이었어요. ③ 두 사람을 한 화면에 넣는 투샷은 아직 어색해요. 한 사람씩 만들어 편집으로 붙이는 화면 분할이 훨씬 자연스러웠습니다. 실제 촬영 문법이 AI에서도 통하더라고요. ✍️ 소감 "한 번에 뽑기"보다 감독처럼 컷을 나누고, 고치고, 붙이는 과정이 결과를 만든다는 걸 느꼈어요. 도구는 이미 충분하고, 차이는 연출과 디테일에서 납니다. 로컬 생성이라 부담 없이 반복할 수 있으니 회사 소식이나 제품 이야기를 영상으로…
The prompt behind it.
The creator has not shared a public prompt. Visit the original post for more about this work.
Video and prompt by Seulki Ji. Original post ↗
Is this your work? Add the badge
Paste this on your site or README to link people to this page.
<a href="https://createmotion.io/motions/x-2112357562876395792/"><img src="https://createmotion.io/featured-on-motif.svg" alt="Featured on motif" width="188" height="44"></a>
Keep exploring.
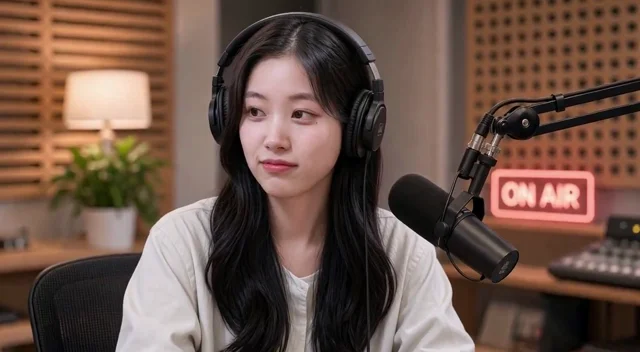 @nakazakifam 님의 AI 비디오 팟캐스트를 보고 저도 ComfyUI로 만들어봤습니다. · Video 2/2By Seulki Ji
 We made a malleable video editing app that lets the user change the interface, completely free and open sourceBy zellzoi
 5 months ago we used an agency and invested thousands of euros for our @NovaRecruiter_ launch video.By Ramon Rodrigáñez